Qwen 3.8 27B และการ run ใน Apple Silicon
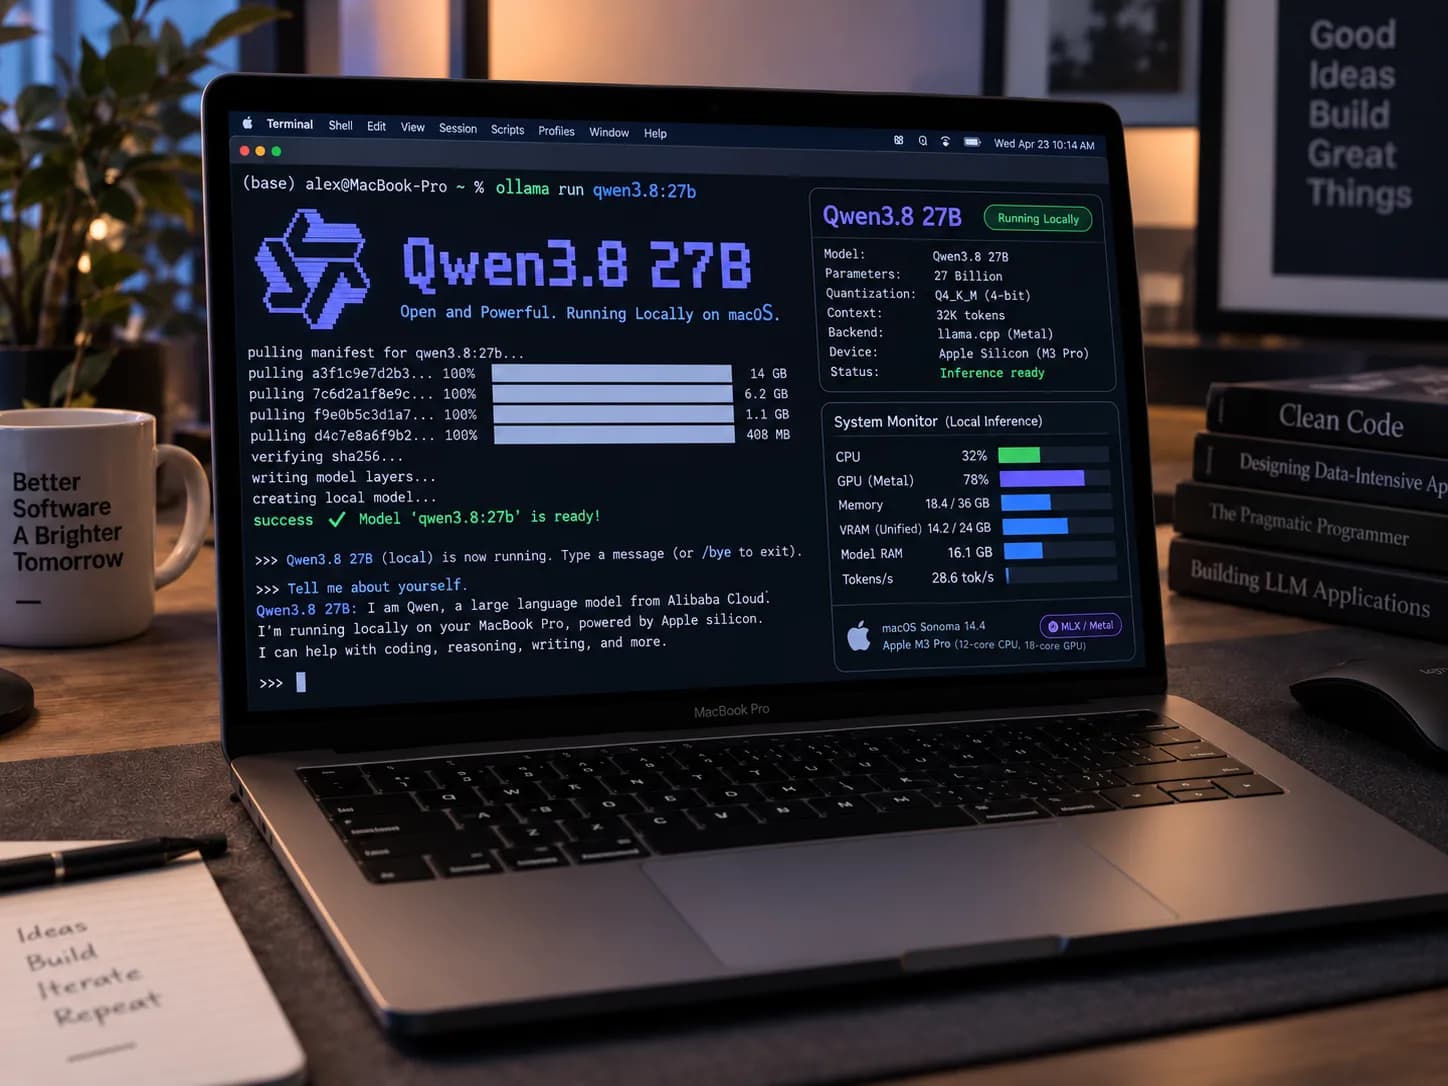
เมื่อกลางเดือนสิงหาคม 2026 ที่ผ่านมา Qwen ปล่อย Qwen3.8-27B ออกมา และกลายเป็นหนึ่งใน local model ที่พูดถึงกันเยอะที่สุดตัวหนึ่งของปีนี้ ทั้งเรื่องความสามารถด้าน coding/agentic ที่แรงเกินตัวเมื่อเทียบกับขนาด และการที่มันรันได้จริงบนเครื่อง consumer อย่าง Mac ที่เรา ๆ ใช้กันทำงานทุกวัน
บทความนี้เราจะพาไล่ตั้งแต่ตัวโมเดลเอง ไปจนถึง Quantization แต่ละแบบ (FP8, MLX, NVFP4) ว่าทำไมสุดท้ายเราเลือกรันแบบ MLX บน Mac ไปจนถึง MTP ที่ช่วยเพิ่ม token speed และ KV Cache ที่เป็นอีกก้อนความจำสำคัญที่มักถูกมองข้าม แล้วปิดท้ายด้วยการเจาะลึกฝั่งฮาร์ดแวร์ Apple Silicon ว่าทำไม unified memory ถึงสำคัญ, ทำไม RAM 32GB ในแต่ละชิปถึงไม่เท่ากัน, ไปจนถึงเรื่อง SRAM ในตัว GPU เทียบกับฝั่ง Nvidia แล้วค่อยกลับมาจบที่ขั้นตอนรันจริงบนเครื่องแบบง่าย ๆ
1. Qwen3.8-27B คือใคร
Qwen3.8-27B เป็น dense model (ไม่ใช่ MoE) ขนาด 27B parameters ที่ปล่อย weights ออกมากลางเดือนสิงหาคม 2026 จุดที่น่าสนใจคือสถาปัตยกรรมข้างในเป็น hybrid attention ผสมกันระหว่าง Gated DeltaNet (linear attention) กับ Gated Attention (attention แบบปกติ) วนกันเป็นแพทเทิร์นตลอด 64 layers ในสัดส่วนประมาณ 3 ต่อ 1 (DeltaNet 3 บล็อกสลับกับ full attention 1 บล็อก) ซึ่งเป็นแนวทางเดียวกับตระกูล Qwen3-Next ที่ต้องการลดต้นทุน compute/memory ของ attention แบบเดิมตอน context ยาวๆ โดยที่ยังคง full attention ไว้บางส่วนเพื่อรักษาคุณภาพ
สเปกคร่าวๆ ที่น่าสนใจ:
- Hidden dimension 5,120, รวม 64 layers
- รองรับ context แบบ native ถึง 262,144 tokens และดึงยาวได้ถึง 1M tokens ด้วยเทคนิคอย่าง YaRN
- เป็น multimodal (vision-language) รับได้ทั้งภาพและวิดีโอ ไม่ใช่ text-only
- มี "thinking mode" เปิดเป็นค่า default พร้อมปรับระดับการคิดผ่าน
reasoning_effortได้ 3 ระดับคือ xhigh (ค่า default), medium และ low และมี MTP (multi-token prediction) module ฝังมาตั้งแต่ตอนเทรน (ในconfig.jsonคือคีย์mtp_num_hidden_layers: 1) ซึ่งเดี๋ยวเราจะพูดถึงในหัวข้อถัดไป
ด้าน benchmark ตัวเลขที่แรงคือฝั่ง coding/agentic Terminal-Bench 2.1 อยู่ที่ 73.0, SWE-bench Pro 61.7, GPQA Diamond 89.2, ฝั่ง vision อย่าง OSWorld-Verified 84.3 และ MathVision 94.6 (แบบ with CI) ถือว่าสูงมากสำหรับโมเดลขนาด 27B ที่รันบนเครื่องเดียวได้ สูงกว่า Opus 4.6 โมเดลรุ่นใหญ่ตอนต้นปี 2026 ซะอีก
2. Quantization: ทำไมไม่ใช้ FP8 หรือ NVFP4 แต่ใช้ MLX
โมเดลตัวเต็มที่ Qwen ปล่อยมามีสองฟอร์แมตหลักคือ BF16 (27B พารามิเตอร์ × 2 bytes ≈ 54GB) และ FP8 checkpoint อย่างเป็นทางการ (ประมาณ 28-29GB) แต่พอพูดถึงการรันบน Mac เรามีตัวเลือก quantization หลักๆ ที่ควรรู้จักอยู่สามแบบ
FP8 เป็น floating point 8-bit (ทั่วไปใช้ฟอร์แมต E4M3/E5M2) ที่ลดขนาดโมเดลลงจาก BF16 ได้ประมาณครึ่งหนึ่ง และ checkpoint ทางการของ Qwen ใช้ fine-grained FP8 แบบ block size 128 และเก็บบาง tensor เป็น BF16 ไว้ จุดแข็งของ FP8 คือถ้ามี hardware tensor core ที่รองรับโดยตรง (เช่น Nvidia Hopper/Ada ขึ้นไป) จะได้ทั้งขนาดที่เล็กลงและความเร็วที่เพิ่มขึ้นพร้อมกัน แต่ฝั่ง Apple ไม่ได้เป็นแบบนั้น จากงาน reverse-engineering ตัว Neural Accelerator ใน GPU ของ A19/M5 พบว่า path การคูณเมทริกซ์ที่ถูกเร่งด้วยฮาร์ดแวร์รองรับ FP16 กับ INT8 เป็นหลัก (BF16 ยังไม่ถูก expose ออกมาด้วยซ้ำ) ไม่มีเส้นทาง FP8 ให้ใช้ พูดง่ายๆ คือต่อให้โหลดไฟล์ FP8 มารันบน Mac ได้ ก็ไม่ได้ speed benefit จากฟอร์แมตนี้ แถมขนาดเกือบ 29GB ก็ยังใหญ่จนอึดอัดสำหรับเครื่องที่มี unified memory 32GB เพราะเรายังไม่ได้พูดถึง KV Cache จาก Context Window ที่ Agent/Chat นั้น ๆ ทำงานเลย
NVFP4 คือฟอร์แมต 4-bit float ของ Nvidia เอง ใช้ scaling แบบลำดับชั้น คือแบ่งเป็นบล็อกละ 16 ค่า แต่ละบล็อกมี scale เป็น FP8 (E4M3) ของตัวเอง แล้วซ้อนทับด้วย global scale ระดับ tensor เป็น FP32 อีกชั้น ทำให้ compress ได้ประมาณ 3.3 เท่าเทียบกับ BF16 และยังคง accuracy ได้ดีกว่า FP4 ธรรมดา แต่ตัวติดคือมันต้องพึ่ง hardware tensor core ของ Nvidia Blackwell (B200) โดยเฉพาะถึงจะได้ speedup จริง ซึ่ง Apple Silicon ไม่มี Blackwell tensor core อยู่แล้ว พูดง่ายๆ คือ NVFP4 เป็นตัวเลือกที่ตัดทิ้งได้เลยถ้าเราไม่ได้ใช้การ์ด Nvidia รุ่นใหม่
MLX quantization คือฟอร์แมต quantization ที่ออกแบบมาสำหรับ Apple Silicon โดยเฉพาะ ใช้วิธี affine quantization แบบแบ่งเป็นกลุ่มย่อยๆ (group-wise) แล้วเก็บ scale กับ zero-point แยกต่อกลุ่ม รองรับได้หลายระดับบิต (เช่น 2, 3, 4, 6, 8-bit) ข้อดีคือมันถูกออกแบบมาให้ทำงานร่วมกับ Metal และ unified memory architecture โดยตรง ไม่ต้องแปลงฟอร์แมตไปมาให้เสีย memory bandwidth เพิ่ม และที่สำคัญคือขนาดไฟล์ลงตัวกับ RAM ของ Mac พอดี ซึ่ง Qwen3.8-27B แบบ MLX 4-bit จาก mlx-community มีขนาด 16.1GB (ส่วน 8-bit อยู่ที่ 29.5GB) เทียบกับ FP8 ที่เกือบ 29GB จะเห็นว่าตัว 4-bit เล็กกว่าเกือบครึ่ง
นี่คือเหตุผลที่เราเลือกรันแบบ MLX 4-bit บน Mac: NVFP4 รันไม่ได้เลยเพราะฮาร์ดแวร์ไม่รองรับ (รันได้แต่ไม่คุ้ม) ส่วน FP8 รันได้แต่ไม่ได้ประโยชน์อะไรและกินพื้นที่มากกว่าที่ควร ในขณะที่ MLX ถูกออกแบบมาให้เข้ากับสถาปัตยกรรมของเครื่องเราตั้งแต่ต้น ทำให้ 27B parameter model ตัวนี้ยัดลงไปใน MacBook 32GB ได้แบบมีที่เหลือให้ระบบและ context ด้วย
3. MTP: ได้ token speed เพิ่ม แลกกับ memory อีกนิดหน่อย
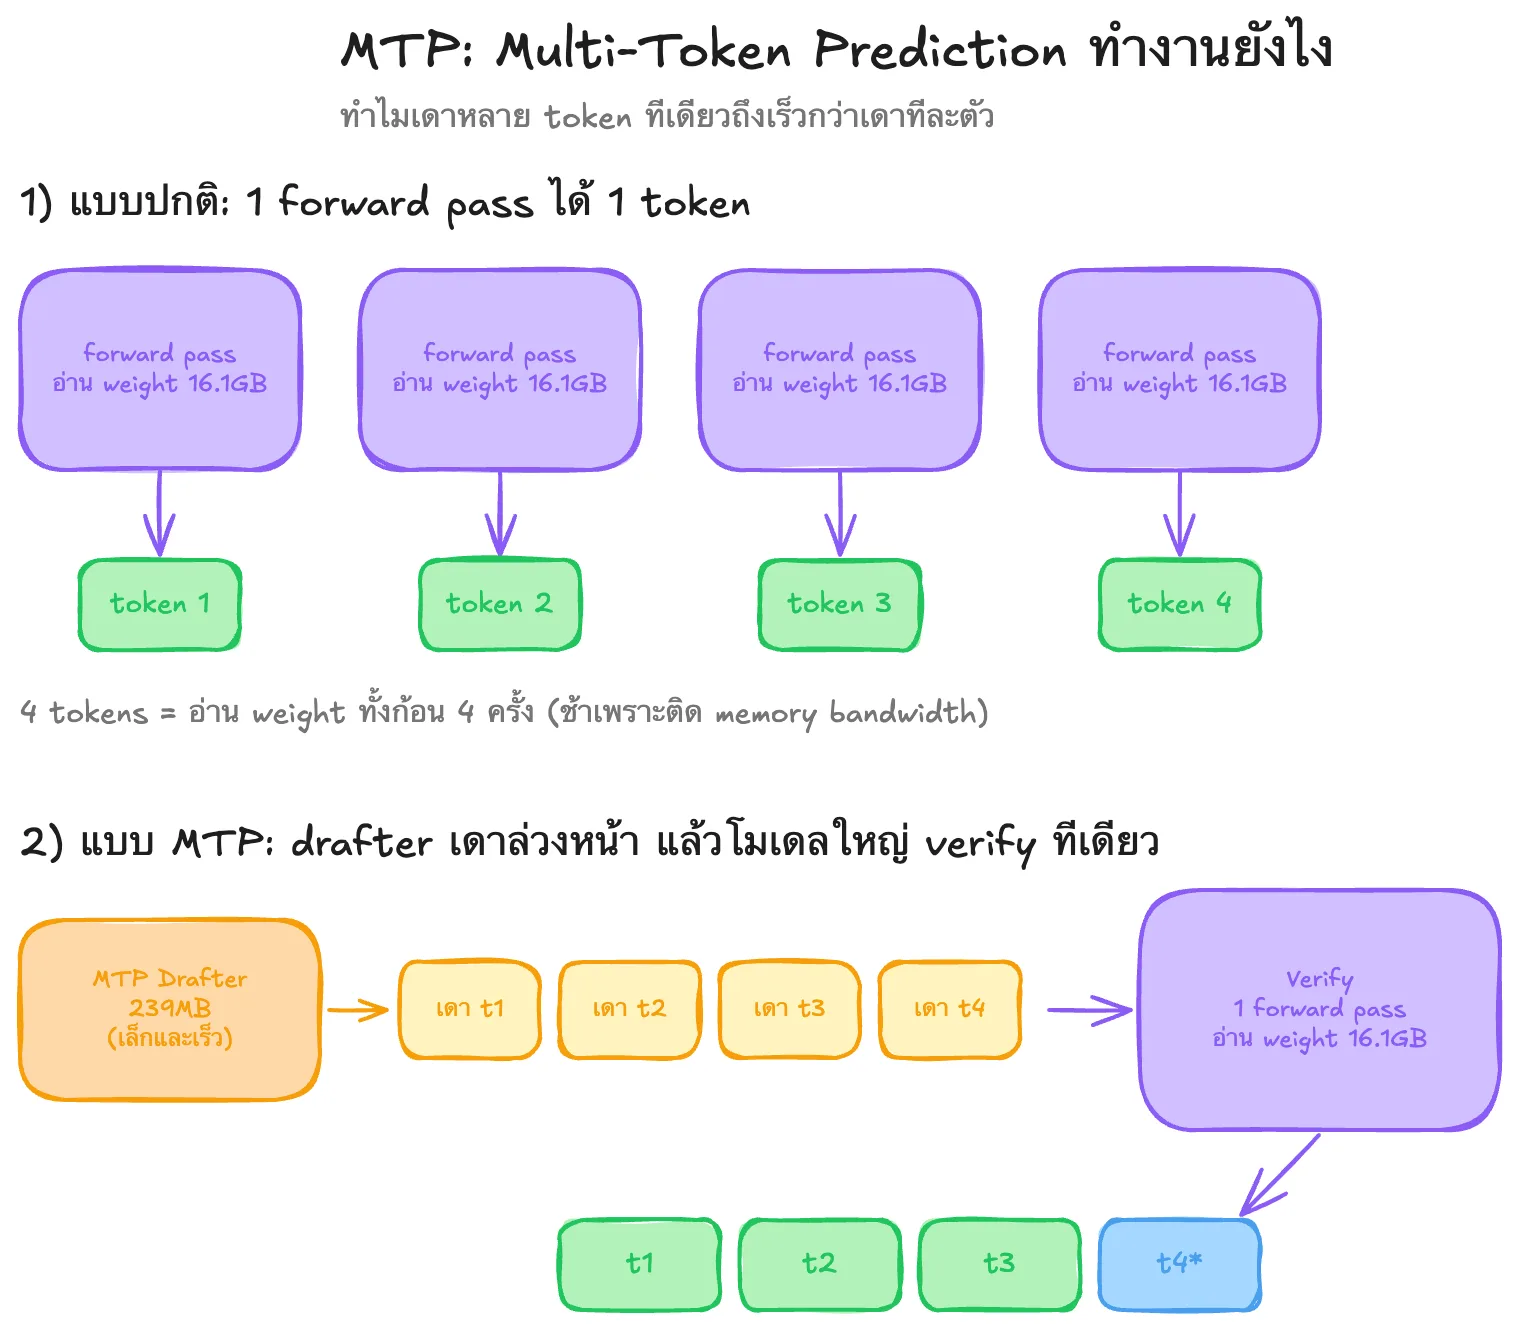
MTP หรือ Multi-Token Prediction คือเทคนิคที่ตอนเทรน โมเดลจะไม่ได้เรียนรู้แค่ทำนาย token ถัดไปตัวเดียว (t+1) แต่มี prediction head เพิ่มเติมให้ทำนาย t+2, t+3 ไปพร้อมกันจาก hidden state เดียวกัน ประโยชน์หลักไม่ได้อยู่ตอนเทรน แต่อยู่ตอน inference ตัว head พวกนี้ถูกเอามาใช้เป็น "draft model" ภายในตัวเองสำหรับทำ speculative decoding คือให้ draft head เดาล่วงหน้าไปหลาย token แล้วให้โมเดลหลักตรวจสอบ (verify) ทีเดียวในการ forward pass เดียว ถ้า token ที่เดาถูกต้องก็ได้มาโดยไม่ต้องผ่าน forward pass เต็มรูปแบบทีละตัว
ทำไมมันถึงช่วยเรื่องความเร็วได้เยอะโดยเฉพาะบน Mac? เพราะขั้นตอน token generation ของ LLM เป็นงานที่ถูก bound ด้วย memory bandwidth เป็นหลัก (รายละเอียดหัวข้อถัดไป) นั่นแปลว่าทุกครั้งที่ต้องสร้าง 1 token ใหม่ เครื่องต้องอ่าน weight ทั้งก้อนของโมเดลผ่าน memory ทีนึงอยู่ดี ไม่ว่าจะสร้างออกมาได้ token เดียวหรือหลาย token MTP เลยเป็นการ "ยืดคุ้ม" การอ่าน memory แต่ละรอบให้ได้ผลลัพธ์หลาย token กลับมาแทนที่จะได้แค่ 1 token ผลคือ tokens/sec เพิ่มขึ้นโดยที่ปริมาณ memory bandwidth ที่ใช้ต่อรอบไม่ได้เพิ่มขึ้นมากนัก
ส่วนที่ "แลกมา" ตามที่พูดถึงคือ memory ต้องโตขึ้นเล็กน้อย เพราะต้องโหลดทั้งโมเดลหลักและตัว draft head ไว้พร้อมกัน ตัวอย่างจริงจาก mlx-community: Qwen3.8-27B-4bit (โมเดลหลัก) มีขนาด 16.1GB ส่วน Qwen3.8-27B-MTP-4bit (drafter สำหรับ speculative decoding) มีขนาดแค่ประมาณ 239MB เพิ่มเข้ามา คิดเป็นสัดส่วนเพิ่มขึ้นแค่ราวๆ 1-2% เท่านั้น ถือว่าคุ้มมากเมื่อเทียบกับ throughput ที่ได้เพิ่ม วิธีรันคือเรียกทั้งสองโมเดลพร้อมกันผ่านแฟล็ก --draft-model ใน mlx_vlm/mlx_lm (รายละเอียดคำสั่งอยู่หัวข้อสุดท้าย)
4. KV Cache: อีกก้อนความจำที่มองข้ามไม่ได้
พอพูดถึง RAM ที่ต้องใช้ หลายคนคิดแค่ "ขนาดไฟล์โมเดล" แต่จริงๆ แล้วมีอีกก้อนหนึ่งที่โตขึ้นเรื่อยๆ ระหว่างใช้งานคือ KV Cache ซึ่งสำคัญพอๆ กับตัว weight โดยเฉพาะกับโมเดลที่โฆษณา context ยาวถึง 262K-1M tokens แบบ Qwen3.8-27B นี้
KV Cache คืออะไร ทุกครั้งที่โมเดล generate token ใหม่ มันต้องคำนวณ attention เทียบกับ token ก่อนหน้าทั้งหมดในบทสนทนา ถ้าคำนวณ Key/Value ของ token เก่าใหม่ทุกรอบจะช้ามาก ระบบเลยแคช Key/Value ของทุก token ที่เคยประมวลผลไปแล้วไว้ใน memory (KV Cache) แล้วเอามาใช้ซ้ำ สูตรคำนวณขนาดคร่าวๆ ต่อ 1 token คือ
kv_per_token_bytes = 2 (K และ V) × จำนวน layer ที่มี attention × จำนวน KV head × head_dim × bytes ต่อค่า
ยิ่ง context ยาว ก้อนนี้ก็ยิ่งบวมขึ้นเรื่อยๆ แบบเชิงเส้นตาม จำนวน token ไม่เกี่ยวกับ quantization ของตัว weight เลย
จุดที่ Qwen3.8-27B ได้เปรียบเพราะสถาปัตยกรรม hybrid attention อย่างที่เล่าไปในหัวข้อ 1 ว่าโมเดลนี้มีแค่ 16 จาก 64 layer เท่านั้นที่เป็น Gated Attention (full attention) แบบดั้งเดิมที่ต้องเก็บ KV cache ที่โตตาม context ส่วนอีก 48 layer ที่เป็น Gated DeltaNet ใช้กลไก delta-rule recurrence เก็บ state เป็นขนาดคงที่ (fixed-size, อัปเดตแบบ rank-1 คล้าย RNN) ไม่ต้องเก็บ Key/Value ของทุก token ย้อนหลังเลย พูดง่ายๆ คือ 75% ของ layer ในโมเดลนี้แทบไม่กิน memory เพิ่มเลยแม้ context จะยาวขึ้นมาก
ลองคำนวณจริงจากค่าใน config.json ของโมเดล (num_key_value_heads: 4, head_dim: 256, num_hidden_layers: 64 และ layer_types ที่เป็น linear 3 ต่อ full 1): ต่อ token ต่อ 1 full-attention layer ใน bf16 คือ 2 × 4 × 256 × 2 bytes = 4KB คูณด้วย 16 layers ที่มี attention จริง = 64KB ต่อ token (ตัวเลขนี้ตรงกับที่คนอื่นวิเคราะห์โมเดลตระกูลเดียวกันไว้ด้วย) เทียบกับถ้าเป็นโมเดล 27B แบบ full attention ทั้ง 64 layer จะกิน KV cache สูงกว่านี้ถึง 4 เท่า
| Context length | KV Cache (bf16, เต็มความละเอียด) | kv-bits 8 | kv-bits 4 |
|---|---|---|---|
| 8K tokens | ~0.5 GB | ~0.25 GB | ~0.125 GB |
| 32K tokens | ~2 GB | ~1 GB | ~0.5 GB |
| 128K tokens | ~8 GB | ~4 GB | ~2 GB |
| 262K tokens (native max) | ~16 GB | ~8 GB | ~4 GB |
จะเห็นว่าที่ context เต็ม 262K ตัว KV cache เพียวๆ กินไปถึง 16GB แล้ว (ใกล้เคียงกับขนาดตัว weight 4-bit เองเลย!) นี่คือเหตุผลที่ mlx-lm/mlx-vlm มีแฟล็ก --kv-bits (เลือกได้ 4 หรือ 8 บิต, group size ปกติ 64) ให้ quantize ตัว KV cache ได้เองแยกจากตัว weight ช่วยลดขนาดลงได้อีก 2-4 เท่าโดยคุณภาพลดลงไม่มาก ยกเว้นงานที่ต้องการความแม่นยำสูงมากๆ (เช่น reasoning ซับซ้อนหรือ long-document retrieval) ที่อาจเห็นความต่างชัดขึ้นบ้าง ข้อควรระวัง: บาง version ของ mlx-vlm (เช่น 0.6.1) เคยมีบั๊กที่ --kv-bits ทำให้โมเดลลืม context ที่ prefill ไปแล้ว (recall ผิดพลาด) ก่อนใช้งานจริงควรเช็ค changelog หรือทดสอบ recall สั้นๆ ก่อนว่า version ที่ใช้แก้บั๊กนี้แล้วหรือยัง
รวมเป็นตาราง RAM ที่แนะนำ คิดจาก weight (4-bit = 16.1GB, 8-bit = 29.5GB) + KV cache ตามตารางข้างบน + เผื่อ macOS กับ runtime อีกราว 6GB:
| Unified Memory | Weight ที่แนะนำ | Context ที่ใช้ได้จริง (KV bf16) | Context ถ้าเปิด kv-bits 4 |
|---|---|---|---|
| 32GB | MLX 4-bit (16.1GB) | ~96K สบาย, 128K แบบตึงๆ | เต็ม 262K (native max) ได้ |
| 48GB | MLX 4-bit (16.1GB) | เต็ม 262K ได้สบาย | เหลือที่เผื่อ extended context |
| 48GB | MLX 8-bit (29.5GB) | ~192K (ยังไม่เต็ม native) | เต็ม 262K ได้ |
| 64GB | MLX 8-bit (29.5GB) | เต็ม 262K + เหลือที่รัน MTP drafter คู่ | เหลือเยอะสำหรับ extended context |
| 96-128GB (M Max) | MLX 8-bit เต็มๆ | รองรับทั้ง native และ extended context ได้สบาย | มีที่เหลือเผื่อรันหลาย session พร้อมกัน |
จะเห็นว่าที่ 48GB การเลือก 8-bit แลกมาด้วย context ที่สั้นลง เพราะ weight กินไป 29.5GB แล้ว ถ้างานเน้น context ยาวมากกว่าคุณภาพระดับสูงสุด อยู่ที่ 4-bit จะคุ้มกว่า ข้อคิดสำคัญคือ อย่าคิดแค่ "weight ใส่พอดี RAM" — ต้องเผื่อ KV cache กับ context ที่ตั้งใจใช้จริงด้วยเสมอ ไม่งั้นพอเปิด context ยาวๆ เครื่องอาจ swap หรือ crash ทั้งที่ตอนโหลดโมเดลอย่างเดียวดูเหมือนจะพอดีก็ได้
5. ทำไม Apple Silicon ถึงนิยมเอามารัน Local AI
เหตุผลหลักคือสถาปัตยกรรม Unified Memory ปกติเครื่องที่มี discrete GPU อย่างการ์ดจอ Nvidia จะมี VRAM แยกต่างหากจาก RAM หลักของระบบ ถ้าโมเดลใหญ่กว่า VRAM ที่การ์ดมี ก็ต้องหาทาง offload บางส่วนไปอยู่ใน RAM ปกติ ซึ่งช้ากว่ามาก หรือไม่ก็ต้องซื้อการ์ดหลายใบต่อกันเพื่อรวม VRAM (การ์ดระดับ data center อย่าง H100 มี VRAM 80GB ต่อใบ ส่วน H200 อยู่ที่ 141GB ราคาต่อใบก็หลักแสนถึงหลักล้านบาท)
Apple Silicon ออกแบบให้ CPU, GPU, และ Neural Engine ใช้ pool memory เดียวกันที่เชื่อมกับชิปโดยตรง (soldered LPDDR5X บน package เดียวกับ SoC) พูดง่ายๆ คือ "VRAM" กับ "RAM" คือก้อนเดียวกัน ทำให้ Mac Studio ที่ซื้อมาพร้อม unified memory 128GB หรือ 512GB (M5 Ultra) กลายเป็นเครื่องที่โหลดโมเดลขนาดใหญ่เข้าไปตรงๆ ได้เลยโดยไม่ต้อง offload อะไร ในราคาที่ถูกกว่าการต่อการ์ด Nvidia หลายใบมาก บวกกับกินไฟน้อยกว่าและเสียงเงียบกว่าเครื่อง server มาก นี่คือเหตุผลหลักที่ทำให้ฝั่ง local AI/self-hosted LLM หันมาสนใจ Mac กันเยอะขึ้นเรื่อยๆ
6. Memory Bandwidth: ตัวแปรที่สำคัญกว่าความจุ RAM
ประเด็นที่มักเข้าใจผิดกันคือคิดว่ามี RAM เยอะพอก็รันได้เร็ว แต่จริงๆ แล้วมีสองเฟสที่ต้องแยกกัน
Prompt processing (prefill) คือช่วงที่โมเดลอ่าน prompt/context ทั้งหมดแล้วประมวลผลแบบขนาน เฟสนี้ compute-bound คือขึ้นอยู่กับพลัง GPU (FLOPs) เป็นหลัก ไม่ใช่ bandwidth งานวิจัยจาก Apple เองเกี่ยวกับ MLX บนชิป M5 ก็ยืนยันแบบนี้ — ที่ M5 มี Neural Accelerator ฝังอยู่ในทุก GPU core ตัว prefill ถึงเร็วขึ้นได้มากถึง 3.3-4 เท่าเทียบกับ M4 เพราะช่วง prefill ใช้ประโยชน์จาก compute หน่วยนี้เต็มที่
Token generation (decode) คือช่วงสร้างคำตอบทีละ token ซึ่งตรงนี้แหละที่ถูก bound ด้วย memory bandwidth เพราะการสร้าง 1 token ใหม่ต้องอ่าน weight เกือบทั้งก้อนของโมเดลผ่าน memory ครั้งหนึ่งเสมอ ไม่ว่า GPU จะแรงแค่ไหนก็ตาม ถ้า bandwidth ไม่พอ ความเร็วก็จะโดนจำกัดอยู่ดี หลักคิดคร่าวๆ คือ tokens/sec สูงสุดตามทฤษฎี ≈ memory bandwidth ÷ ขนาด weight ที่ต้องอ่านต่อ 1 token ซึ่งอธิบายได้ว่าทำไมโมเดลเดียวกัน แต่รันบนชิปที่ bandwidth สูงกว่าถึงเร็วกว่าอย่างเห็นได้ชัด อย่างที่ Apple รายงานเองว่าแค่ bandwidth เพิ่มจาก 120GB/s (M4) เป็น 153GB/s (M5) ก็ทำให้ token generation เร็วขึ้น 19-27% แล้วทั้งที่ตัว GPU compute เพิ่มขึ้นมากกว่านั้นมาก
7. ทำไม RAM 32GB ในแต่ละชิปตระกูล M ถึงไม่เท่ากัน
ตรงนี้คือสิ่งที่หลายคนสับสน — RAM 32GB ที่ซื้อมากับชิป M ธรรมดา, M Pro, M Max, หรือ M Ultra ความจุเท่ากันแต่ "ประสิทธิภาพ" ไม่เท่ากันเลย เพราะตัวเลขที่สำคัญจริงๆ คือ bandwidth (GB/s) ซึ่งขึ้นอยู่กับจำนวน memory channel/bus width ที่ชิปแต่ละรุ่นออกแบบมา ไม่ใช่ความจุ
ลองดูตารางเทียบในตระกูล M5 ที่เป็นเจนล่าสุด (ข้อมูลจาก Apple newsroom และหน้า tech specs ปี 2025-2026):
| ชิป | GPU cores | Memory Bandwidth | Max Unified Memory |
|---|---|---|---|
| M5 (base) | 10-core | 153 GB/s | 32GB |
| M5 Pro | สูงสุด 20-core | สูงสุด 307 GB/s | 64GB |
| M5 Max | 32-core / 40-core | 460 GB/s (32-core) หรือ 614 GB/s (40-core) | 128GB |
| M5 Ultra | สูงสุด 80-core | สูงสุด 1.2 TB/s | 512GB |
| M6 (base รุ่นถัดมา, ส.ค. 2026) | 12-core | 170 GB/s | 32GB |
จะเห็นว่าจาก M5 พื้นฐานไป M5 Ultra bandwidth ต่างกันเกือบ 8 เท่า ลองเทียบให้เห็นภาพชัดๆ: MacBook Pro ที่ใส่ M5 base 32GB (153GB/s) กับ M5 Max รุ่นเริ่มต้น 36GB (460GB/s) ความจุ RAM ต่างกันแค่ 4GB แต่ bandwidth ต่างกัน 3 เท่า ซึ่งส่งผลโดยตรงกับความเร็วตอน decode แบบเกือบเป็นสัดส่วนตรง เพราะ Pro/Max/Ultra มี memory channel มากกว่า
ที่น่าสนใจกว่านั้นคือ แม้แต่ชิปชื่อเดียวกันก็ยังไม่เท่ากัน — M5 Max รุ่น GPU 32-core ได้ bandwidth 460GB/s ส่วนรุ่น 40-core ได้ 614GB/s ต่างกันเกือบ 35% ทั้งที่กล่องเขียนว่า "M5 Max" เหมือนกัน ตอนเลือกสเปกจึงต้องดูจำนวน GPU core ควบคู่ไปด้วยเสมอ
ถ้าอยากได้ตัวอย่างเทียบกับรุ่นเก่าหน่อย เครื่องส่วนตัวของผมเองเป็น M2 Max 32GB ซึ่งมี GPU 38-core และ bandwidth 400GB/s (Apple, 2023) จะเห็นว่าแม้เป็นคนละเจนกับ M5 แต่ M2 Max ก็ยังมี bandwidth สูงกว่า M5 หรือ M6 รุ่น base เสียอีก เพราะ Max เป็น die คนละขนาดกับ base ทั้งที่ต่างเจนกัน และนี่คือเหตุผลที่การเลือกซื้อ Mac มารัน local LLM ต้องดู "รุ่นชิป" (Pro/Max/Ultra) ไม่ใช่ดูแค่ตัวเลข GB ของ RAM หรือรุ่นปีอย่างเดียว
8. Compute unit และ Neural unit ของแต่ละรุ่น: ใครทำหน้าที่อะไรตอนรัน MLX
อีกจุดที่มักสับสนคือ Apple มีหน่วยประมวลผลด้าน AI อยู่สองส่วนที่ทำงานคนละหน้าที่กัน
Neural Engine (ANE) เป็นหน่วยแยกที่ Apple ใส่มาตั้งแต่ A11/M1 ใช้สำหรับงานที่รันผ่าน CoreML เป็นหลัก เช่นฟีเจอร์ Apple Intelligence, ตรวจจับใบหน้าในรูป, ปรับภาพวิดีโอ ฯลฯ ตัวเลข TOPS ที่ Apple เคยประกาศ เช่น M2 อยู่ที่ 15.8 TOPS จาก Neural Engine 16-core แต่ MLX (ที่ใช้รัน Qwen3.8-27B) ไม่ได้ใช้ ANE เป็นหลัก แต่มันรันผ่าน GPU เป็นหลักผ่าน Metal
GPU + Neural Accelerator คือส่วนที่สำคัญจริงๆ สำหรับงานนี้ ตั้งแต่เจน M5 เป็นต้นมา Apple เพิ่ม "Neural Accelerator" เข้าไปในทุก GPU core โดยตรง ทำหน้าที่เร่งการคูณเมทริกซ์ (matrix multiplication) ซึ่งเป็นการคำนวณหลักของ LLM inference จุดนี้ทำให้ prefill เร็วขึ้นชัดเจนอย่างที่พูดถึงในหัวข้อก่อนหน้า ส่วน GPU core count ในแต่ละรุ่นก็คือปัจจัยตรงที่กำหนด raw compute สำหรับตอน prefill: M5 มี 10-core, M5 Pro สูงสุด 20-core, M5 Max สูงสุด 40-core, M5 Ultra สูงสุด 80-core (เพราะ Ultra คือเอา Max สองตัวมาเชื่อมกันด้วย UltraFusion และเนื่องจาก M5 Max เองก็เป็นดีไซน์ 2 die อยู่แล้ว ตัว M5 Ultra จึงกลายเป็น quad-die เป็นครั้งแรกของตระกูล M)
สรุปสั้นๆ คือถ้าจะเลือกซื้อ Mac มารัน MLX/LLM: ดู GPU core count และ memory bandwidth เป็นหลัก ไม่ต้องสนใจตัวเลข Neural Engine TOPS มากนัก เพราะงานนี้ไม่ได้พึ่ง ANE โดยตรง
9. เจาะลึก SRAM ใน GPU: Apple เทียบกับ Nvidia
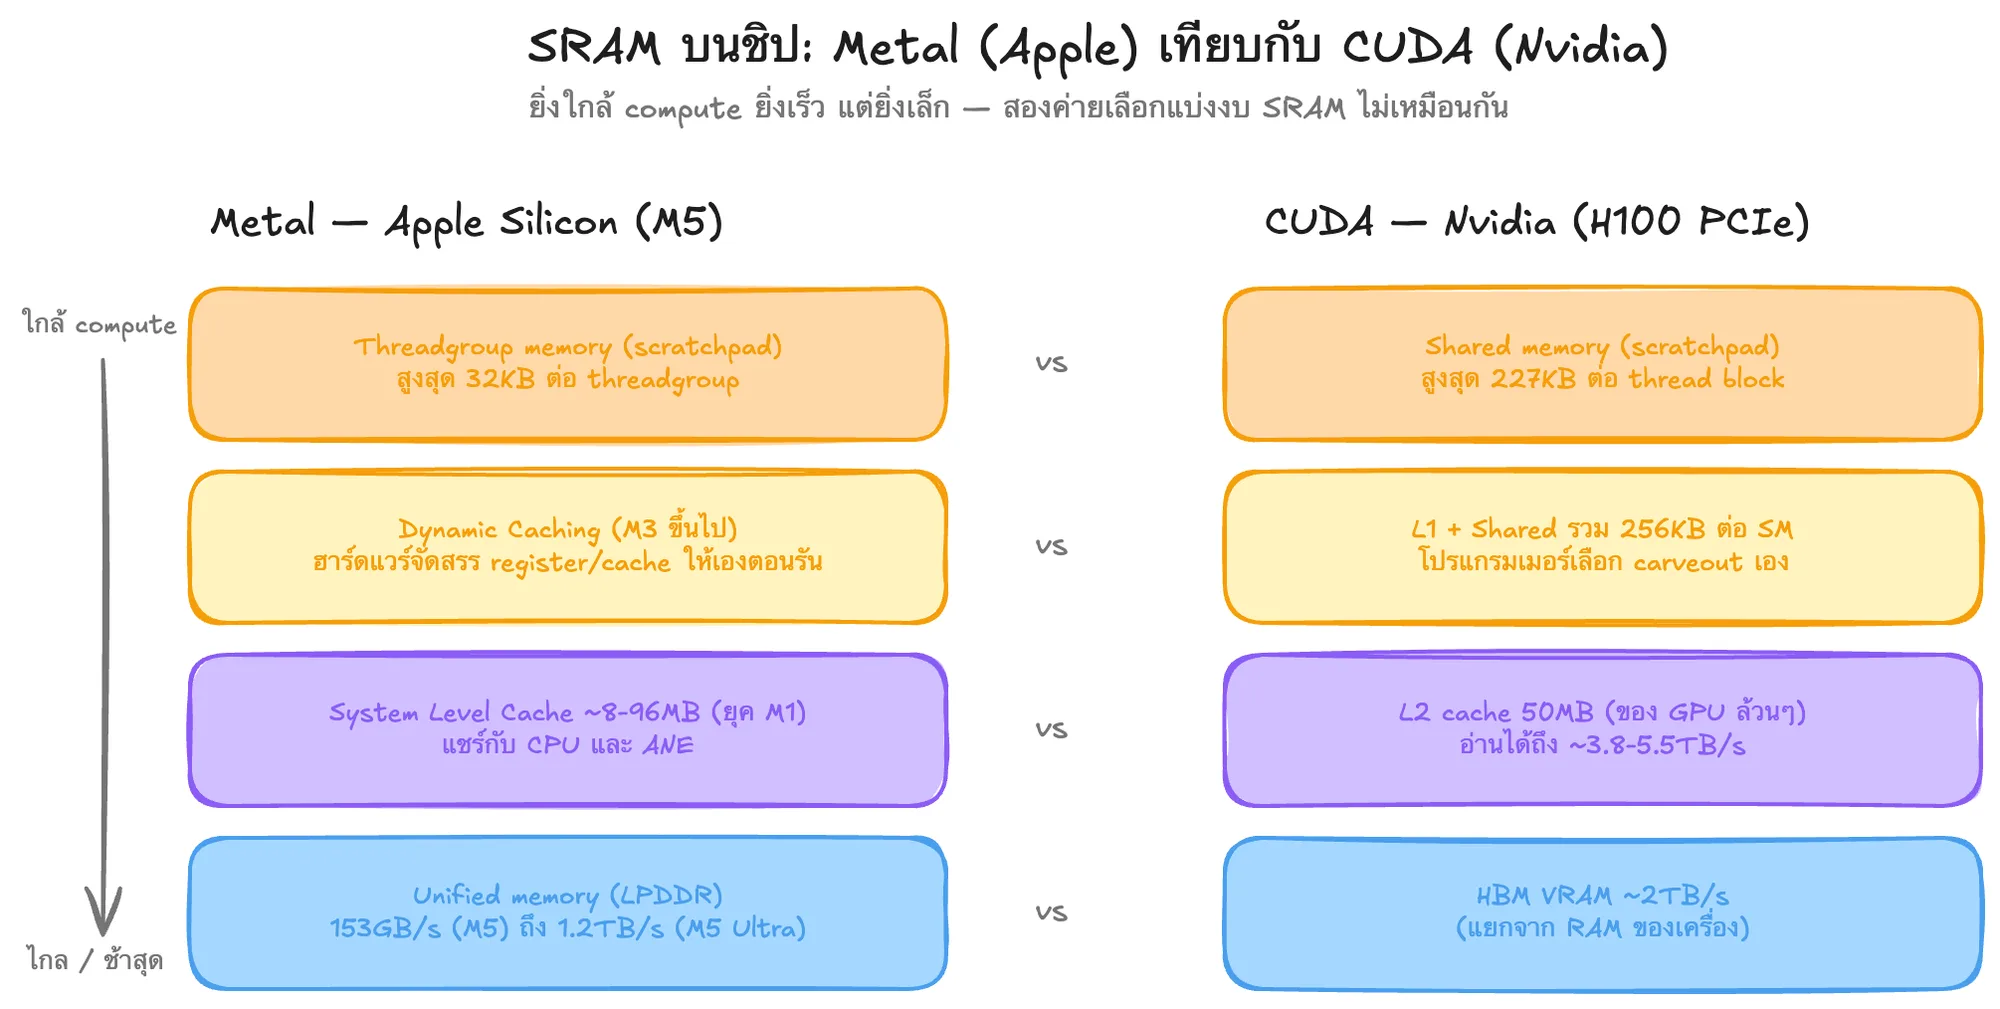
อีกมุมที่น่าสนใจในเชิงสถาปัตยกรรมคือขนาด on-chip cache/SRAM ของ GPU สองค่ายนี้ต่างกันโดยปรัชญา
ฝั่ง Apple ใช้สิ่งที่เรียกว่า System Level Cache (SLC) เป็น cache ก้อนใหญ่ที่แชร์ร่วมกันระหว่าง CPU, GPU และหน่วยประมวลผลอื่นๆ บนชิป ขนาดของมันแตกต่างกันไปตาม tier ของชิป ยกตัวอย่างที่มีตัวเลขชัดเจนคือรุ่น M1 ที่ไล่ตั้งแต่ราว 8MB ในรุ่นพื้นฐานไปจนถึงราว 96MB ในรุ่น Ultra (Apple ไม่ได้ประกาศตัวเลขนี้อย่างเป็นทางการในรุ่นหลังๆ) เพราะสถาปัตยกรรม unified memory ของ Apple ไม่จำเป็นต้องมี cache ก้อนใหญ่มากเพื่อ "กันชน" ระหว่าง CPU กับ GPU เหมือนดีไซน์ discrete GPU เนื่องจากทุกอย่างใช้ pool memory เดียวกันอยู่แล้ว
ฝั่ง Nvidia ดีไซน์เน้นไปทาง SRAM cache ที่ใหญ่และเร็วมากเพื่อป้อนข้อมูลให้ tensor core ที่หิวข้อมูลมหาศาล เช่น H100 (รุ่น PCIe) มี L2 cache สูงถึง 50MB แบ่งเป็นสองพาร์ทิชัน bandwidth การอ่านจาก L2 ฝั่งใกล้ (near partition) สูงกว่า 5.5 TB/s และในระดับ per-SM (streaming multiprocessor) แต่ละตัวยังมี L1 cache/shared memory รวมกันถึง 256KB ต่อ SM (เพิ่มจาก 192KB ใน A100) ส่วน VRAM bandwidth ของ H100 เองก็สูงเกือบ 2TB/s จาก HBM2e ปรัชญาของ Nvidia คือ "ยัด cache ให้ใหญ่และเร็วที่สุดเท่าที่จะทำได้" เพื่อลด latency ในการป้อนข้อมูลให้ compute unit ที่แรงมากๆ ซึ่งเหมาะกับงาน training/serving ระดับ data center ที่ throughput ต้องสูงสุดๆ
พูดให้เห็นภาพคือ Apple เลือกดีไซน์แบบประหยัดพลังงานและง่ายต่อการแชร์ข้อมูลข้ามหน่วยประมวลผล (เหมาะกับโน้ตบุ๊ก/เดสก์ท็อปที่กินไฟจำกัด) ในขณะที่ Nvidia เลือกดีไซน์แบบอัดพลัง raw throughput เต็มที่โดยไม่สนเรื่องพลังงานมากเท่า (การ์ด H100 กินไฟ 300-700W ต่อใบ) ทั้งสองแนวทางนี้เป็นเหตุผลหนึ่งที่ inference ของโมเดลขนาดเดียวกันบน Mac จะช้ากว่าการ์ด Nvidia ระดับ data center พอสมควรในแง่ raw tokens/sec แต่ก็แลกมาด้วยการที่เราสามารถมี unified memory ก้อนใหญ่ในราคาที่เข้าถึงได้ และใช้ไฟน้อยกว่ามาก
10. กลับมาที่วิธีรัน Qwen3.8-27B บน Mac จริงๆ
หลังจากเข้าใจภาพรวมทั้งหมดแล้ว มาดูขั้นตอนจริงกัน
ติดตั้ง MLX runtime (สำหรับโมเดลนี้ต้องใช้ mlx-vlm เพราะ Qwen3.8-27B เป็น vision-language model ไม่ใช่ text-only):
pip install -U mlx-vlm
ดาวน์โหลดและรันแบบ 4-bit (ไฟล์ 16.1GB เหมาะกับเครื่อง unified memory 32GB ขึ้นไป):
python -m mlx_vlm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --max-tokens 512 \
  --temperature 0.0 \
  --prompt "เขียน quicksort เป็นภาษา Python"
ถ้าต้องการคุณภาพสูงขึ้นและมี RAM เหลือเฟือ (แนะนำ 64GB ขึ้นไป) ให้เปลี่ยนไปใช้ตัว 8-bit (mlx-community/Qwen3.8-27B-8bit ขนาด 29.5GB) แทน 4-bit เพื่อรักษาคุณภาพงาน vision ได้ดีกว่า แต่ 48GB ก็รันได้แค่จะเหลือที่ให้ KV cache น้อยลง ทำให้ context ยาวสุดสั้นลงตามไปด้วย
เปิดใช้ MTP (speculative decoding) เพื่อเพิ่ม tokens/sec: โหลดโมเดลหลักคู่กับ drafter ที่ mlx-community เตรียมไว้ให้ (รูปแบบคำสั่งตามที่ระบุใน model card — บาง version เรียกผ่าน python -m mlx_vlm.generate แทน)
mlx_vlm generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --draft-model mlx-community/Qwen3.8-27B-MTP-4bit \
  --prompt "Write a quicksort in Python."
หรือถ้าอยากได้ OpenAI-compatible API ไว้ต่อกับเครื่องมืออื่น ใช้ mlx_lm.server เปิดเป็น local server ที่ localhost แล้วยิง request แบบเดียวกับเรียก OpenAI API ได้เลย
ข้อแนะนำเรื่อง RAM: กลับไปดูตารางในหัวข้อ 4 ได้เลย สรุปสั้นๆ คือ 32GB พอไหวสำหรับ 4-bit ที่ context ระดับ ~96K, 48GB รัน 4-bit ได้เต็ม context 262K, ส่วน 64GB ขึ้นไปคือจุดที่สบายที่สุดถ้าอยากรัน 8-bit คู่กับ context ยาวๆ พร้อม MTP drafter ไปด้วย ถ้า RAM เริ่มตึงให้ลองเปิด --kv-bits 4 หรือ --kv-bits 8 ตอนรันเพื่อบีบ KV cache ลงอีก (แต่เช็ค version ของ mlx-vlm ก่อนตามที่พูดถึงในหัวข้อ 4) และไม่ว่า config ไหนก็ควรเผื่อ headroom ให้ระบบปฏิบัติการอีกสัก 15-20% ของ unified memory ทั้งหมดเสมอ
สรุป
Qwen3.8-27B เป็นตัวอย่างที่ดีของยุคที่ open-weight model ขนาดกลางแรงพอจะใช้งานจริงได้ และ Apple Silicon ก็พัฒนามาถึงจุดที่ unified memory บวกกับ MLX ที่ออกแบบมาเฉพาะทางทำให้เรารันโมเดลระดับ 27B บนโน้ตบุ๊กเครื่องเดียวได้แบบไม่ต้องพึ่ง cloud GPU เลือก MLX quantization เพราะมันคือฟอร์แมตที่เข้ากับสถาปัตยกรรมเครื่องเรามากที่สุด เปิด MTP เพื่อบีบ tokens/sec เพิ่มโดยแลกกับ memory แค่หลักร้อย MB และเข้าใจว่า bandwidth ต่างหากที่เป็นคอขวดตัวจริงของ token generation ไม่ใช่แค่ตัวเลข GB ของ RAM
อ้างอิง
- Qwen/Qwen3.8-27B บน Hugging Face และ config.json
- Qwen/Qwen3.8-27B-FP8 (checkpoint FP8 ทางการ)
- Qwen3.8-27B: Performance, benchmarks, GPU requirements & how to run it — Northflank
- Qwen 3.8 27B is excellent, but it defaults to wildly overthinking things — Simon Willison
- mlx-community/Qwen3.8-27B-4bit
- mlx-community/Qwen3.8-27B-8bit
- mlx-community/Qwen3.8-27B-MTP-4bit
- Accelerating large language models with NVFP4 quantization — Red Hat Developer
- Investigating the GPU Neural Accelerators on Apple A19/M5 — Taras Zakharko
- Multi-Token Prediction (MTP) — Sebastian Raschka
- Qwen3.6 and the KV Cache Constraint: Local-First Long-Context — wal.sh
- KV Cache and Context Length on Apple Silicon: The Memory Math for Local Inference — Contra Collective
- mlx-swift-lm KV cache reference — GitHub
- Quantized KV cache (--kv-bits) context-recall bug — mlx-vlm Issue #1310
- Apple unleashes M5 — Apple Newsroom
- Apple debuts M5 Pro and M5 Max — Apple Newsroom
- MacBook Pro (16-inch, M5 Pro หรือ M5 Max) Tech Specs — Apple Support
- Apple introduces M6 and M5 Ultra — Apple Newsroom
- Apple unveils M2 Pro and M2 Max — Apple Newsroom
- Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU — Apple Machine Learning Research
- Apple Silicon: Memory and internal storage — Eclectic Light Company
- Nvidia's H100: Funny L2, and Tons of Bandwidth — Chips and Cheese
- MLX systematic inference benchmarks on M3 Ultra — GitHub Discussion
- mlx-lm — GitHub
- MLX LM — Qwen docs